分享到:
- 微信
- 微博
分享到微信打开微信,点击底部的“发现”, |



{{aisd}}
AI生成 免责声明
机器人大脑发育所需的数据,就藏在普通人的生活里。
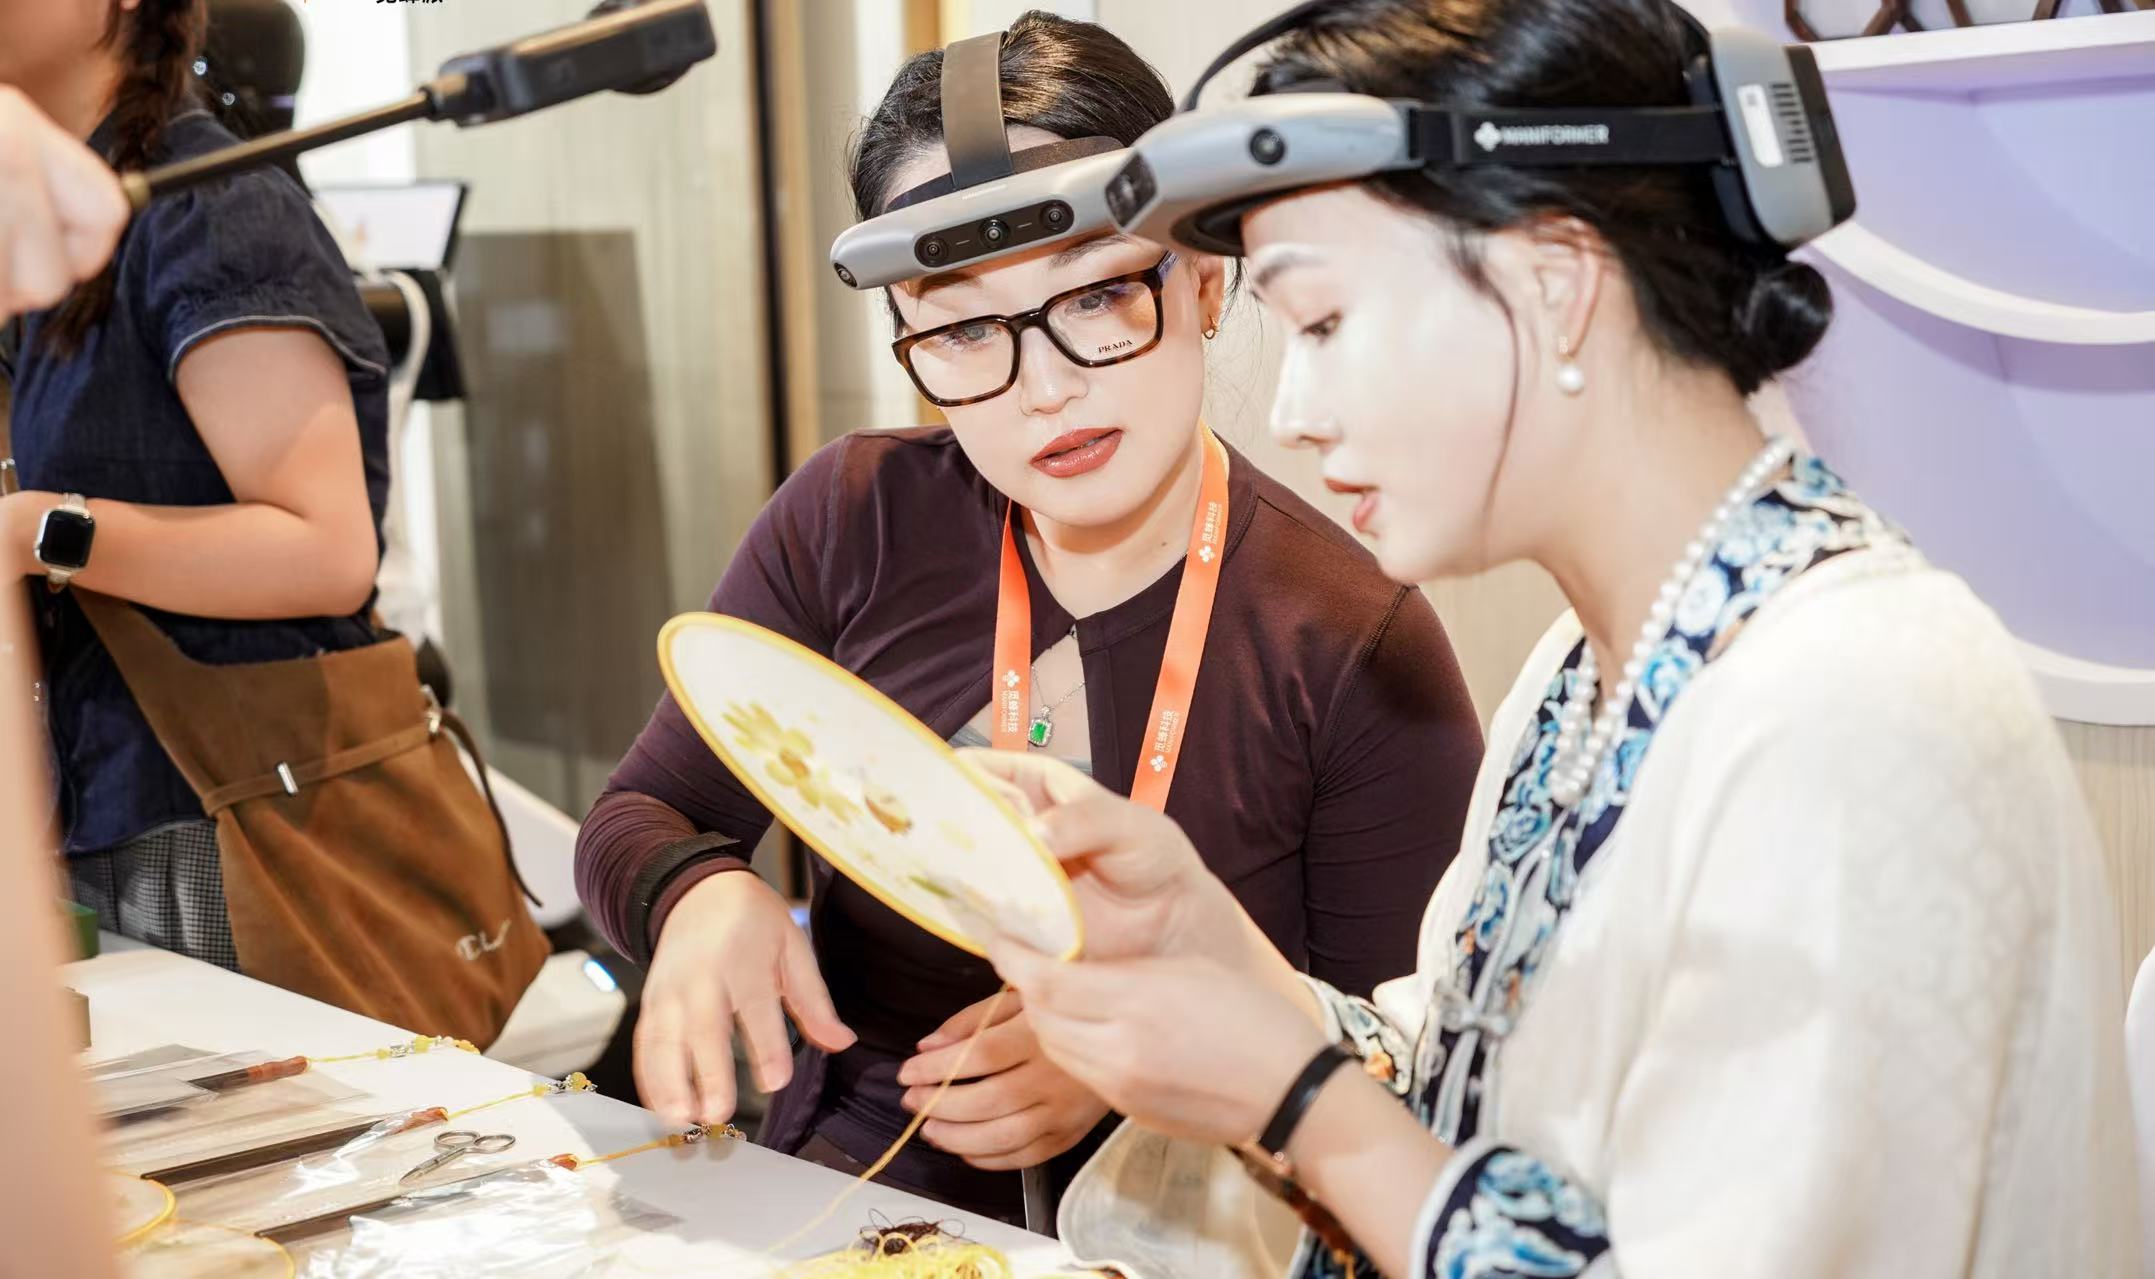
近日,觅蜂科技启用数据采集众包平台,希望佩戴数采设备的千千万万普通人能够把制作月饼、侍弄花草、快递分拣等日常行为数据汇聚起来,用于训练机器人的大脑。
机器人所需数据量急剧增长,国内已经有众多数据采集平台。但数据质量比数量更加重要,这考验数据采集平台:那些重复、低质数据,不但无益于人工智能,反倒像是给机器人投毒。
数据依赖度大了
9月23日,觅蜂科技发布全球首个全品类物理AI数据众包服务平台“觅蜂派”。
“物理AI最好的老师,是每一个认真生活的人。”觅蜂科技董事长兼 CEO 姚卯青在现场表示。这一平台希望将分散在日常生活和千行百业中的真实操作经验,转化为机器人可以学习、训练和复用的数据。
觅蜂派面向社会开放物理AI数据采集任务,用户佩戴数采设备后可以在零售、仓储、制造等真实场景中完成Ego数据的采集。
所谓Ego数据,是指以第一人称视角所获取的行为数据,它与仿真数据(虚拟环境中生成的数据)、遥操机器人采集的数据等在精度、数量等方面均有所区别。
据姚卯青介绍,Ego数据可用于大模型、世界模型早期预训练阶段,提升基础模型泛化能力。“它的特点是少量时候发现不了有多大帮助,到比较大规模之后,才能逐步激活一些涌现能力。小模型,小数据量做单一场景应该不是它最适用的场景。”
每种不同的数据,都有它的阶段性价值,也有它们各自的问题。
“Ego数据有助于覆盖更多真实场景和任务,但其训练价值需要结合采集方式和具体用途判断。例如‘头环+裸手’采集的数据,如果重建精度误差过大,这部分轨迹作为精细操作训练信号的价值很大一部分就打折了。”蚂蚁灵波CEO朱兴在外滩大会上接受记者采访时表示。
在朱兴看来,判断数据价值要看训练阶段,仿真数据更多用于中后期训练,尤其是在提升特定任务成功率的时候更有价值。
今年七月份,蚂蚁灵波一口气发布了六款模型。蚂蚁灵波所需的训练数据,很大比例由外部供应商采集,但采集什么数据、覆盖哪些场景和任务,由蚂蚁灵波根据模型训练需求来定义。
“现在数据很重要,未来更重要。”朱兴说,一些采集难度比较高的数据,蚂蚁灵波还要先试采,形成比较好的标准作业流程,然后再推给供应商上量。
迫切需要数据的还有魔芯科技。
“世界模型训练最需要的是反映真实物理世界、体现物理规律的数据。比如车在路上是怎么开的,人在路上是怎么走的,泥石流形成的时候水是怎么冲击的,等等。”魔芯科技相关负责人对第一财经记者说。
魔芯科技在7月发布基于华为NPU构建的世界模型MoWorld,模型参数约为140亿。魔芯科技用到的数据,需求量也大,数据质量的要求也高,所以数据标注这类环节的工程量非常大。
“比如拍一段视频,需要一帧一帧标注里面的物体运动速度、物体质量、质地、摩擦力等指标。所以数据生产的成本比较高。”郭力说。
目前对真实世界数据有迫切需求的公司有三大类。一类是具身智能公司,它们有本体也有算法,希望做自己的基座模型;一类是新创的世界模型公司,它们不做本体,但会用到比较多的数据做预训练;还有一类是大模型厂商,已经消耗完互联网数据,进一步提升模型能力则必须采纳真实世界的数据。
姚卯青观察到,具身智能对于数据依赖越来越大。去年上半年,很少有公司提几十万小时的数据需求,到了去年年底就有客户提出20万小时的需求,而今年已经不少公司提出100万小时数据需求了。“我们接触到的用户,有些在提千万小时的数据需求。”
吃不了“粗粮”
“数据量固然重要,但不能只谈量,更要谈质量和分布。”朱兴表示。分布尤其重要,它是模型厂商最核心的技巧,产业常将训练模型比作“炼丹”,“炼丹背后就是数据的配方。”
不管哪类数据源、数据采集方式,往往都存在大量的场景重复。这类过度重复的数据意义不大。以自动驾驶为例,车企采集到的数据,往往只是增加了存储成本,真能提升智能的关键数据已经很难得了。姚卯青认为,现在机器人叠衣服的数据也已经泛滥了。
具身智能发展的早期,数据稀缺的情况下,厂商们将一切可得的数据投喂给模型。但朱兴的观察是,具身智能吃不了“粗粮”。一些具身模型的训练数据量比另外一个模型大3倍、5倍,但在一些场景任务上效果更差,原因就在于数据分布的极度不均衡。
蚂蚁灵波自去年年初就不大量购买成品数据了,转而按模型训练需求定制采集。该公司对于数据的重视,从数据供应商生产初期就开始了,而不是等着数据摆上货架再行购买。
“我们跟所有的供应商合作,数据交付一般都不是做批量交付,而是流式交付。作为模型厂商,我要把数据管线做得更高效,对数据认知更深,这是核心壁垒,离开这个东西谈模型没有意义。”朱兴说。
他认为,目前数采工厂众多,而数据高度重复,产业未来会更加分化。一类数采工厂将主要提供基础数据采集服务,另一类则具备更强的数据管线能力,能够与模型公司形成持续、高效的协同。
姚卯青同样觉得,数采行业必然出现整合。
现在机器人训练对数据的要求,几乎没有初创团队能够拿得出来。
“你给一千小时数据订单,初创公司一个月都不一定能交得出来。但是头部客户都是一周要交5万、10万小时的数据量,没有足够资源支撑很难做到这一点。”姚卯青说。
数采行业拼的是质量、运营能力,而且还是重资金投入的行业。采集设备、人员、数据处理、海量存储等都需要投入。比如觅蜂科技应对1000万小时的数据采集需求,需要大几亿的固定资产投入。
数采行业日益发展,行业分工就不可避免。姚卯青认为,数采企业不会都掌控整个链条,而是一些公司提供数据采集能力,一些公司做运营工作,还有一些公司做数据的处理加工、分发。
真实世界数据的质和量的问题,不只是魔芯科技和蚂蚁灵波的难题,而是所有物理AI训练中都会遇到的问题。不过,这可能成为中国企业的竞争优势。
“中国获得真实世界数据的成本,比美国获得数据的成本要低。人力比较便宜,推进工程项目的质量更高,做数采和标注反而是中国企业的优势了。”一家企业的负责人表示。
如需获得授权请联系第一财经版权部:banquan@yicai.com
文章作者
AI三大投入中,普通企业只有一张牌
对企业家而言,数据质量将成为AI时代竞争力分化的重要来源,值得战略级的重视。
欧洲企业CEO们,不想错失中国机器人浪潮
欧洲并不在AI变革的舞台中心,但欧洲企业不想错过它。
越疆科技A股过会后停滞:账上24亿现金仍要募12亿,有何隐情?
25亿买定存?越疆回A的另一番考量,可能是股东退出
具身赛道“遮羞布”被揭开:数采中心的“内循环”生意还能做多久
有行业人士反馈称,一些地方政府对数采中心的态度正在变得谨慎。
AI浪潮下的智能替代与螺旋上升——2026外滩大会见解论坛聚焦人机共生
论坛从产业、人本、治理三大维度展开深度研讨,多维思辨AI时代的机遇与潜在挑战,共同展望人机共生的可持续未来。