分享到:
- 微信
- 微博
分享到微信打开微信,点击底部的“发现”, |
高价值数据依然短缺,数据“用得好”最后一公里卡在哪
第一财经 2026-10-31 18:05:48
作者:金叶子 责编:杨志


{{aisd}}
AI生成 免责声明
随着人工智能技术爆发后日均词元(Token)调用量的突破,数据从“供得出”到如何更好“用得上”成为业内关注的话题。
“52.26ZB的数据总量中,真正被有效利用的占比仅约3%。”在10月30日开幕的2026全球数商大会上一场“数、链、智协同”的产业圆桌对话上,上海数据集团首席技术官苏光牛分享了这组数据。
仍缺乏高质量数据
“数据的供出已经不是问题,跑通流程也不是问题,但支撑行业高价值的数据依然短缺。”苏光牛说,数据流通的瓶颈正从通道转向“好不好”。
在具身智能赛道,数据短缺的问题凸显。它石智航副总裁刘华说,具身智能泛化性面临较大阻碍,核心在数据。要训练出强泛化性的基座模型,数据门槛是“千万小时级”,而目前行业高质量训练数据仅停留在百万小时级,“缺口大概在90%”。
尤其是采集成本与模态缺陷方面。刘华分享称,传统真机遥操作设备一套二三十万元,真机本身数十万元,调测一天往往只能产出几个小时合格数据。更深层的硬伤在于数据模态的失真:“现在非常多的基座模型主要依靠文本和视频训练,看起来能听懂指令、能看懂世界,但根本不理解‘力’和物理动作的真实含义。机器人做动作时缺乏手感,极容易翻车。”
在刘华看来,弥补触觉与姿态等关键模态,从自采、机器人数据回流到外采跨越千万小时门槛,行业至少还需要两到三年才能迎来“ChatGPT时刻”。
对于运营商来说,智能体的发展也在倒逼底座设施的重建。中兴通讯副总裁兼企业发展部总经理黄义华表示,产业正从人联网迈向智联网,预计到2030年全球智能体规模将突破22亿,增长超80倍。与之伴随的,是从“比特”彻底转向“Token”,算力基础设施从拼单卡指标转向考验多芯协同、软硬件一体的全栈工程。
另外,当大模型加速向AI Agent(智能体)演进时,底层计算资源也遭遇了结构性问题。
海光信息技术股份有限公司副总裁应志伟在现场举例道,去年跑文本与代码生成等大模型任务,算力基本由GPU扛起;但今年Agent落地后,工程师发现大模型生成代码后,伴随大量的编译、运行和测试,这些流程会大量消耗CPU算力。
“这个时候GPU反而会空转。程序员并行任务的激增,更进一步加速了对CPU的消耗。”应志伟透露,为了避免算力空转与瓶颈,业界CPU与GPU的配置比例正被动地从过去的1:1向1:4甚至1:8快速推移。
算力重组之外,更大的问题是“裸奔”的安全顾虑。到2025年底,全国智能算力规模将达到1590eFlops,但苏光牛认为,技术工程化之后,瓶颈已经全面推向了“制度的信任”。
企业把Prompt(提示词)和核心材料输入云端大模型,本质上是将敏感数据以明文全盘托出。针对这一问题,阿里云智能集团副总裁霍嘉提出,信任必须分立为“数据要素可信”与“数据应用可信”,当前产业必须解决模型思考时的思维链数据与Token全链路加密问题。
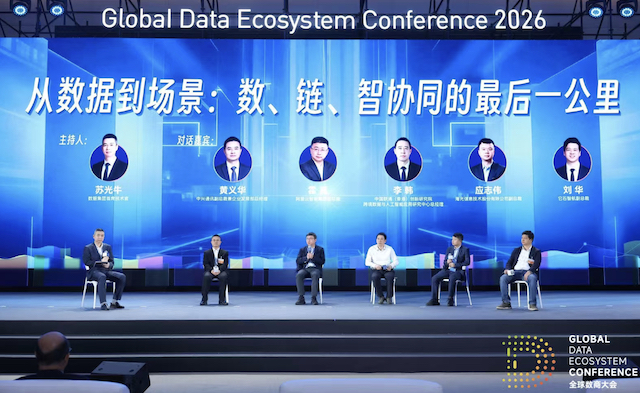
要告别“Demo秀”
部分在场嘉宾认为,数据应用商业模式难以闭环的根源,在于行业充斥着不少“伪场景”,应该告别“Demo秀”。
霍嘉在圆桌中谈到“AI+”落地时表示:“我看到很多企业的AI+应用,基本以Demo型应用为主,生产级看不见;不少应用只是给几个人做的玩具,解决不了广泛的生产力提效问题。”
他认为,能够跑通商业价值的数据场景必须具备严苛的硬指标:是能发挥机器不眠不休优势的“24x7场景”、必须深度接入前沿基础模型、且必须形成“应用到效果反馈”的数据飞轮闭环。
霍嘉以兰州石化常减压装置为例分析称,由于停机代价极大,此前依赖人工24小时紧盯大盘,通过打造智能体接管实时调整并连续稳定运行五个月,AI才算第一次真正切入核心生产系统。
不仅是场景需要剥离泡沫,技术手段同样在经历重估。针对苏光牛提出的“利用区块链与智能合约解决数据授权与收益分配”的设想,李韩认为,各地都在建可信数据空间,但标准碎片化、缺乏法律保障等还存在问题。
中国联通(香港)创新研究院跨境数据与人工智能应用研究中心总经理李韩说,孤立地谈论原始数据值多少钱是空谈,必须把数据拆解为生产、治理、产品化、运营等不同链条,数据只有与技术融合产品化后才有生产价值,利益分配也只能依据各方在全链路中的实际价值创造来分割。
刘华也认为,数据的定价终究要交由市场机制决定,当具身智能模型能力因高质量数据跃升而带来巨额收益时,市场自然会给数据开出合理对价,而链上追溯应服务于对劳动者、场景方与采集方的精细化确权。
如需获得授权请联系第一财经版权部:banquan@yicai.com
文章作者

2026全球数商大会10月30日开幕!以“数智共生 链接世界”打造国际数据要素交流平台
现场将发布多个行业高质量数据集,推动数据集开源社区共建。
荣誉将至丨2026“数据要素×”大赛上海分赛颁奖仪式将在全球数商大会举行
多个在上海分赛中脱颖而出的优秀项目斩获一等奖。
数据产业的培育,需要一场“能力建设长跑”
数据交易所的功能正在从“促成交易”向“综合服务”拓展,价格发现、合规保障、供需匹配等基础能力尚在建设之中。
新央企国家数据集团成立,要解决哪些“老大难”问题
在省级层面,北京、上海、江苏、四川、湖北、陕西、湖南、河南、福建等省份均已组建省级数据集团。
收盘|创业板指跌1.62% 宁德时代跌12%
全市场超3300只个股下跌。